はてなブログだと数式がうまく表示されないのでHackMDに書きました。
話題として気になっていたので、ゼロ次最適化の次元依存下限とクレジット割当問題の観点から考察してみました。
この記事では,ニューラルネットワークを乱数初期化のまま学習させたときに発生する 「初期化の罠」 を整理し,その回避策としての事前学習を原理から紹介します.Transformer や ResNet がどうして安定的に学習できるのか.最新の理論をもとに掘り下げながら,「事前学習モデルを微調整するのが一番コスパが良い理由」を示したいと思います.
深層モデルの損失関数は高次元かつ非凸ですが,実際には Transformer や ResNet がサクッと収束するケースのほうが多いです.ところが,小規模データをゼロから Transformer で Fine‑Tune しようとすると,勾配が発散したり精度がガタ落ちしたりするシーンが報告されています.たとえば Spider (∼7 k 訓練例) では,標準初期化の Transformer は 8 層超で学習が完全に破綻することが報告されています[1].
一方で,BERT などの事前学習済み重みを読み込んで数エポックだけ微調整すると,安定的かつ高精度で着地します.BERT は 2.5 k 例しかない RTE にも 3 エポックで 70 % 超の SOTA を達成しています[2].
なぜ「スクラッチ学習」と「事前学習+微調整」でこんなに差がつくのでしょうか.ここで鍵になるのが損失ランドスケープの形状と初期値の位置関係です.そこで,まずは次の二点を確かめてみることにします.
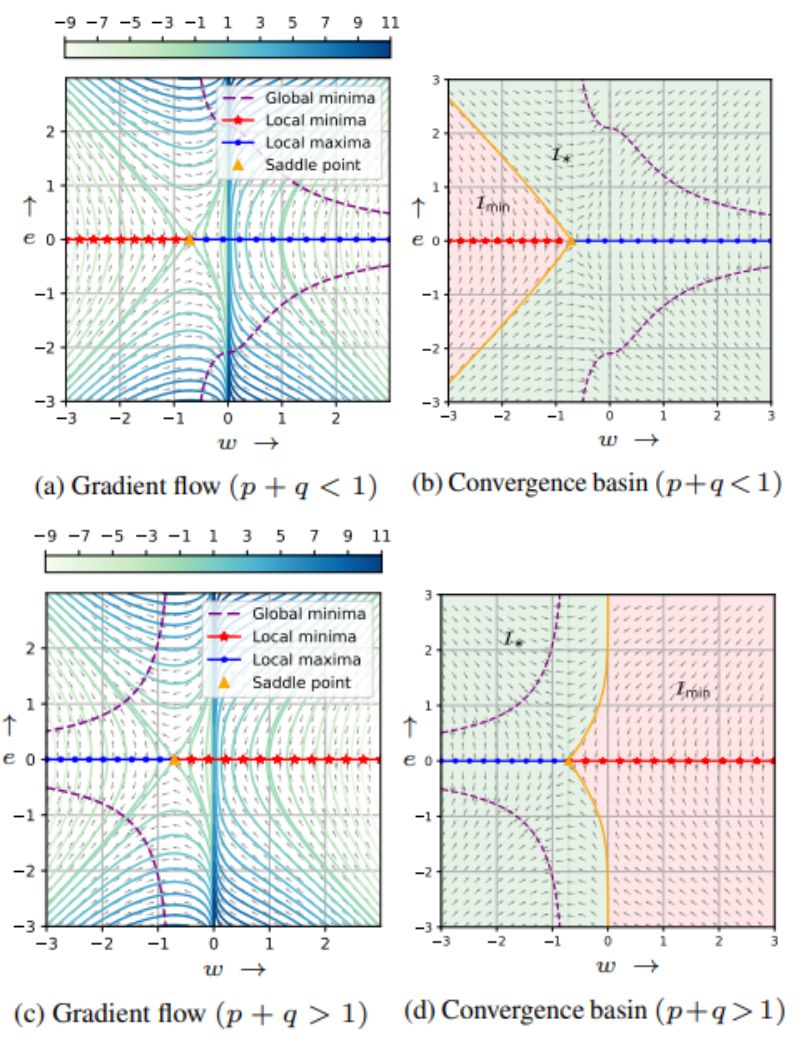
Makkuva ら[3]は「1 層 Transformer × 1 次 Markov データ」を厳密に解析し,初期値が 良性領域 I★に入ると必ず大域最適へ流れ着き,I★ を外すと局所極小で足踏みすることを示しました.I★ に含まれる条件は「重みスケール×Markov 遷移確率」の不等式で書けるのですが標準ガウス初期化だと高確率で I★ を外すと主張しています.
図1では,
という 2 軸で平面を描き,その上に
緑=大域最適へ流れ込む領域 I★,赤=局所極小で足踏みする領域 を色分けしています.
結論だけつまむと,
この2つを図が対照的に描き出しており,「安全域に入り込むには,事前学習で座標を合わせておくとよい」ということが導かれます.
要するに,事前学習重みは「データの揺らぎに合わせてスケールが調律済み」なので,最初から I★ の真ん中にワープできるということになります.
| 理論結果 | ランドスケープの性質 | 初期化・モデル幅との関係 |
|---|---|---|
| ResNet(Kawaguchi & Bengio, 2019)[4] | 残差接続で悪い局所極小ゼロ | ガウス初期化でもかなり安全 |
| 重み減衰付き二層 ReLU の凸最適化(Lacotte & Pilanci, 2020)[5] | 重み減衰付きで凸問題に帰着 | 隠れユニット数が臨界値に達すると 悪い局所極小が消滅し,損失景観が “凸的” になる |
| オーバーパラメータ化 ReLUネットワーク(Karhadkar et al., 2024)[6] | ほとんどの領域で局所=大域 | 幅を増やすほど安全域が拡張 |
要は,幅を盛る・残差を挿す・正則化をかけると損失谷が「平らでつながった安全地帯」に変形します.でも その谷にたどり着けるかは初期値の運次第と言えます.事前学習は谷への近道を作る,というわけです.
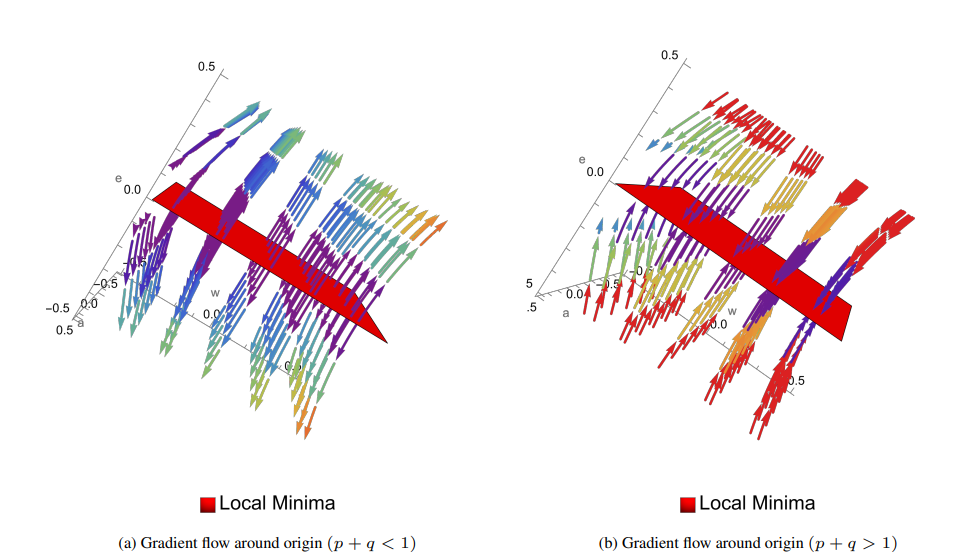
良性領域へのショートカット
事前学習済み重みは Transformer の I★,ResNet のフラットな谷など,安全地帯を初期位置にしてくれます.
表現多様体の事前獲得
自己教師あり学習により低ランク&情報圧縮された構造が重み空間に刻まれ,下流タスクの損失が滑らか&低次元化します [7, 8, 14–16].
データ効率の向上
PAC-Bayes1 的には「良い先験」を持つほど少サンプルでも一般化保証が強まります.自己教師ありで得た事前分布を解析した研究では,ImageNet のラベル数を 1/10 まで削っても性能を保てることが示されています [9].
最適化の安定化
勾配爆発/消失の元凶はスケール不整合.事前学習重みは層ごとのスケールが整っているため,学習率を上げても収束が速く確実になると報告されています [11, 17].
フラット方向を利用した微調整
過パラメータ化で生じる“フラット多様体”上を低エネルギーで移動できるため破滅的忘却が抑えられます.LoRA や Adapter 手法がごく少ない更新量で済むのは,事前学習後にパラメータ空間の有効次元が大幅に圧縮されているからだと説明されています [12, 13].
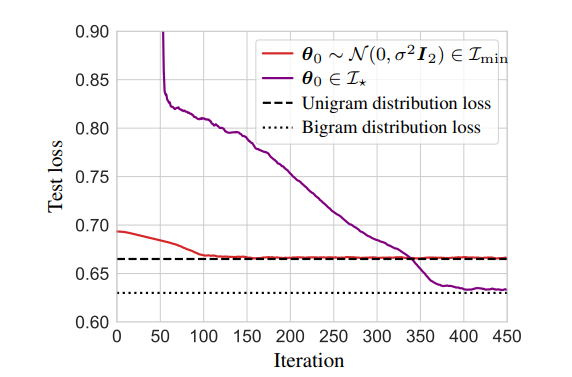
具体的には,1 次 Markov データの遷移確率 p(0→1)と q(1→0)の和が 1 を超える,つまり「状態がコロコロ入れ替わる」厳しい条件(p + q > 1)を想定します.この設定では,標準ガウス初期化 (σ = 0.02) だと学習がユニグラム並みの損失に沈んでしまいます.一方で,理論に基づいて重みを e = 0.5,W₁ = 1,W₂ = −1 に置くとバイグラムの最適損失までストンと収束します.しかもそのあいだ,重み行列はずっとランク 1 を維持、低ランク初期化の強みが数字にも図にもはっきり現れています.
[1] Peng Xu, Dhruv Kumar, Wei Yang, Wenjie Zi, Keyi Tang, Chenyang Huang, Jackie Chi Kit Cheung, Simon J. D. Prince, and Yanshuai Cao, “Optimizing Deeper Transformers on Small Datasets,” arXiv preprint arXiv:2012.15355 (v4), May 2021 — ACL 2021 採択.
[2] Jacob Devlin, Ming-Wei Chang, Kenton Lee, and Kristina Toutanova, “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding,” Proceedings of NAACL-HLT 2019, pp. 4171–4186, June 2019.
[3] Ashok Vardhan Makkuva, Marco Bondaschi, Chanakya Ekbote, Adway Girish, Alliot Nagle, Hyeji Kim, and Michael Gastpar, “Local to Global: Learning Dynamics and Effect of Initialization for Transformers,” arXiv preprint arXiv:2406.03072, June 2024.
[4] Kenji Kawaguchi and Yoshua Bengio, “Depth with Nonlinearity Creates No Bad Local Minima in ResNets,” Neural Networks, vol. 118, pp. 167–174, 2019.
[5] Yifei Wang, Jonathan Lacotte, and Mert Pilanci, “The Hidden Convex Optimization Landscape of Two-Layer ReLU Neural Networks: An Exact Characterization of the Optimal Solutions,” arXiv preprint arXiv:2006.05900, June 2020.
[6] Kedar Karhadkar, Michael Murray, Hanna Tseran, and Guido F. Montúfar, “Mildly Overparameterized ReLU Networks Have a Favorable Loss Landscape,” arXiv preprint arXiv:2305.19510 (v3), February 2024.
[7] Hanxun Huang, Ricardo J. G. B. Campello, Sarah M. Erfani, Xingjun Ma, Michael E. Houle, and James Bailey, “LDReg: Local Dimensionality Regularized Self-Supervised Learning,” arXiv preprint arXiv:2401.10474 (v2), March 2024 — ICLR 2024 採択.
[8] Ravid Shwartz-Ziv, Amichai Painsky, and Naftali Tishby, “Representation Compression and Generalization in Deep Neural Networks,” Proceedings of ICLR 2019, May 2019.
[9] Ting Chen, Simon Kornblith, Mohammad Norouzi, and Geoffrey Hinton, “Big Self-Supervised Models Are Strong Semi-Supervised Learners,” arXiv preprint arXiv:2006.10029, June 2020 — NeurIPS 2020 (SimCLRv2).
[10] David Berthelot, Nicholas Carlini, Ian Goodfellow, Nicolas Papernot, Avital Oliver, and Colin A. Raffel, “MixMatch: A Holistic Approach to Semi-Supervised Learning,” Proceedings of NeurIPS 2019, December 2019.
[11] Hongyu Wang, Shuming Ma, Li Dong, Shaohan Huang, Dongdong Zhang, and Furu Wei, “DeepNet: Scaling Transformers to 1,000 Layers,” arXiv preprint arXiv:2203.00555, March 2022.
[12] Armen Aghajanyan, Sonal Gupta, and Luke Zettlemoyer, “Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning,” Proceedings of the 59th Annual Meeting of the Association for Computational Linguistics (ACL 2021), pp. 7319–7328, August 2021.
[13] Edward J. Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shane Wang, and Weizhu Chen, “LoRA: Low-Rank Adaptation of Large Language Models,” Proceedings of ICLR 2023, May 2023.
[14] Hao Li, Zheng Xu, Gavin Taylor, Christoph Studer, and Tom Goldstein, “Visualizing the Loss Landscape of Neural Nets,” Advances in Neural Information Processing Systems 31 (NeurIPS 2018), December 2018.
[15] Stanislav Fort and Stanislaw Jastrzebski, “Large Scale Structure of Neural Network Loss Landscapes,” Advances in Neural Information Processing Systems 32 (NeurIPS 2019), pp. 6706–6714, December 2019.
[16] Behrooz Ghorbani, Shankar Krishnan, and Ying Xiao, “An Investigation into Neural Net Optimization via Hessian Eigenvalue Density,” Proceedings of the 36th International Conference on Machine Learning (ICML 2019), pp. 2232–2241, June 2019.
[17] Akhil Kedia, Mohd Abbas Zaidi, Sushil Khyalia, Jungho Jung, Harshith Goka, and Haejun Lee, “Transformers Get Stable: An End-to-End Signal Propagation Theory for Language Models,” arXiv preprint arXiv:2403.09635, March 2024 — ICML 2024 採択.
だいぶ前に書いていたコードですが、C++でTD型の自動微分を実装したので公開します。 自動微分については以下の記事を参考にさせていただきました。
C++書いたコードは以下の通り。 自分が書いたコードはC++14に対応していましたが、話題のChatGPTを用いて、C++17に対応するようにリファクタリングしてもらいました。
Variable::backward でグラフを幅優先探索で辿ってる以外はクラスの定義や演算子オーバーロードを行っているだけなので、スッと読めると思います。
#include <iostream>
#include <deque>
#include <unordered_set>
#include <vector>
#include <memory>
#include <tuple>
#include <functional>

template <typename T>
auto enumerate(T &container)
{
  std::vector<std::tuple<std::size_t, decltype(*std::begin(container)) &>> enumerated;
  std::size_t index = 0;
  for (auto &item : container)
  {
    enumerated.emplace_back(index, item);
    ++index;
  }
  return enumerated;
}

class Function;
class Variable;

class Variable
{
public:
  double data;
  double grad;
  std::shared_ptr<Function> creator;

  Variable(const double data)
      : data(data), grad(1.0), creator(nullptr) {}

  void set_creator(const std::shared_ptr<Function> &gen_func)
  {
    creator = gen_func;
  }

  void backward();
};

class Function : public std::enable_shared_from_this<Function>
{
public:
  std::vector<std::shared_ptr<Variable>> inputs;
  std::shared_ptr<Variable> output;

  std::shared_ptr<Variable> operator()(const std::shared_ptr<Function> &self, const std::shared_ptr<Variable> &input1, const std::shared_ptr<Variable> &input2 = nullptr)
  {
    inputs = {input1, input2};
    const double y = forward();
    output = std::make_shared<Variable>(y);
    output->set_creator(self);

    return output;
  }

  virtual double forward() const = 0;
  virtual std::vector<std::shared_ptr<Variable>> backward(const double gy) const = 0;
};

class Add : public Function, public std::enable_shared_from_this<Add>
{
public:
  double forward() const override
  {
    return inputs[0]->data + inputs[1]->data;
  }

  std::vector<std::shared_ptr<Variable>> backward(const double gy) const override
  {
    return {std::make_shared<Variable>(gy), std::make_shared<Variable>(gy)};
  }
};

class Mul : public Function, public std::enable_shared_from_this<Mul>
{
public:
  double forward() const override
  {
    return inputs[0]->data * inputs[1]->data;
  }

  std::vector<std::shared_ptr<Variable>> backward(const double gy) const override
  {
    return {std::make_shared<Variable>(gy * inputs[1]->data),
            std::make_shared<Variable>(gy * inputs[0]->data)};
  }
};

std::shared_ptr<Variable> operator+(const std::shared_ptr<Variable> &lhs, const std::shared_ptr<Variable> &rhs)
{
  auto add_func = std::make_shared<Add>();
  return add_func->operator()(add_func, lhs, rhs);
}

std::shared_ptr<Variable> operator*(const std::shared_ptr<Variable> &lhs, const std::shared_ptr<Variable> &rhs)
{
  auto mul_func = std::make_shared<Mul>();
  return mul_func->operator()(mul_func, lhs, rhs);
}

std::shared_ptr<Variable> operator+(const std::shared_ptr<Variable> &lhs, const double rhs)
{
  auto rhs_var = std::make_shared<Variable>(rhs);
  return lhs + rhs_var;
}

std::shared_ptr<Variable> operator+(const double lhs, const std::shared_ptr<Variable> &rhs)
{
  auto lhs_var = std::make_shared<Variable>(lhs);
  return lhs_var + rhs;
}

std::shared_ptr<Variable> operator*(const std::shared_ptr<Variable> &lhs, const double rhs)
{
  auto rhs_var = std::make_shared<Variable>(rhs);
  return lhs * rhs_var;
}

std::shared_ptr<Variable> operator*(const double lhs, const std::shared_ptr<Variable> &rhs)
{
  auto lhs_var = std::make_shared<Variable>(lhs);
  return lhs_var * rhs;
}

void Variable::backward()
{
  if (creator == nullptr)
  {
    return;
  }

  std::unordered_set<size_t> visited;
  std::deque<std::shared_ptr<Function>> queue{creator};

  while (!queue.empty())
  {
    auto function = queue.front();
    auto output = function->output;
    auto gy = output->grad;
    auto gxs = function->backward(gy);

    queue.pop_front();

    for (const auto &[i, gx] : enumerate(gxs))
    {
      auto x = function->inputs[i];

      if (gx == nullptr)
      {
        continue;
      }

      std::size_t id_x = std::hash<std::shared_ptr<Variable>>{}(x);
      if (x->creator != nullptr)
      {
        queue.push_back(x->creator);
      }

      if (visited.find(id_x) == visited.end())
      {
        x->grad = gx->data;
        visited.insert(id_x);
      }
      else
      {
        x->grad += gx->data;
      }
    }
  }
}

int main()
{
  auto x = std::make_shared<Variable>(1.0);
  auto y = std::make_shared<Variable>(1.0);

  auto z = x * x + 2 * x * y + y ;
  std::cout << "z = x * x + 2 * x * y + y " << std::endl;
  z->backward();

  std::cout << "x = " << x->data << ", x.grad = " << x->grad << std::endl;
  std::cout << "y = " << y->data << ", y.grad = " << y->grad << std::endl;

  return 0;
}
コンパイルと実行は以下の通りです。
$ clang++ -std=c++17 main.cpp
$ ./a.out
C++も好きな言語ではあるんですが、今後はRustを使って何か実装できたらいいなと考えています。
この記事はDeep Learning Advent Calendar 2016 3日目の記事です.
とうとうAdventCalendar以外でブログを更新しなくなってしまいましたが,元気よく書いていきたいと思います.
今回はニューラルネットのブラックボックス性とその解析をしている論文の紹介です.Deep Learning Advent Calendarをやるぞ!と言っておきながら,この記事で取り上げるのは浅いニューラルネットです.
ニューラルネットは自然言語処理や音声認識,ゲームAIなどの様々なタスクに応用されるようになり,いずれも大きな成果を挙げていることに間違いはありません.
しかしその一方で,ニューラルネットは中間層を挟むため,学習で得られる内部状態は不明瞭となります.このことから,結果の考察がしにくいという理由で忌避されることも多いと思います*1.
この問題は1980年代後半から議論されています.議論は中間層の素子数と目的関数の近似誤差の関係に着目するという方向性となり,"基底となる関数を自由に選べるという条件下で,中間層素子が無限にあれば任意の関数を近似できる"という命題のもと,様々な証明のテクニックが考案されました.Irie, Miyake, Cybenko,Whiteらは,フーリエスライス定理やラドン変換などの概念に基づいて,この命題を証明しています[1, 2, 3].Funahashiはまた,Kolmogorov-Arnoldの定理とSprecherの定理を使って証明を与えています[4].
この議論を進めていくうちに,Anzellottiは,目的関数のクラスを限ると,3層ネットワークの平均二乗誤差の上限は中間層の数に反比例することを示しました[5].それは多層ネットワークと勾配降下法を用いた手法が,次元の呪い*2に束縛されないことを意味しています.
1996年にMurata[6],1998年にはCandes[7]が,ニューラルネットの非線形変換に適したRidge関数を用いて,Ridge関数の積分変換と逆変換を定義し,この積分表現(後述します)を利用することで,Murataらは単純な3層ネットワークの中間層の素子に直接的な意味を与えられることを示しました. このアイデアは,3層ネットワークの関数近似の問題を過完備基底関数系上での展開と捉え.その近似性能を論じたものです.
積分表現はニューラルネットを関数解析的に扱えるという大きなメリットがあります.この積分表現について,少しだけ触れていきたいと思います.
まずはRidge関数の積分表現です.
Ridege関数の積分表現は以下のリンク先で書いたので,こちらを参照して頂きたいと思います.
MurataはこのRidge関数の積分変換を3層ネットワークに取り入れることで,中間素子数nの3層ネットワークの平均二乗誤差がオーダ1/n以下で近似できると定量的に示しました.
その後,Sonodaらはこの理論を発展させ,活性化関数の新しいデファクトスタンダードであるRectified Linear Unit (ReLU)を用いた場合でも,3層ネットワークが上記で示した万能近似性能を有していることを示しています[8].
活性関数ηを持つニューラルネット(3層ネットワーク)の関数 \( f : \mathbb{R}^m → \mathbb{C} \)の近似を以下のように定義します.
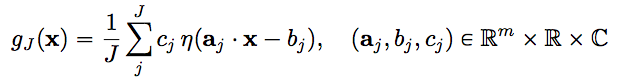
この時,\( (a_j, b_j) \) は中間層(hidden layer)のパラメータで,\( c_j \)は出力層のパラメータです. このニューラルネット\( g_J(x) \)は,以下のニューラルネットの積分表現を離散化することによって得ることができます.
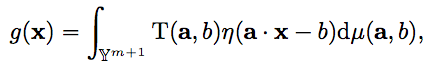
ニューラルネットの和の部分を積分に置き換え,連続化した関数を得ることを積分表現といいます.
\( \mathbb{Y}^{m+1} \) は中間層のパラメータ空間 \( \mathbb{R}^m \times \mathbb{R} \)です.右辺は,ηに対するT(a, b)の双対リッジレット変換とされています.
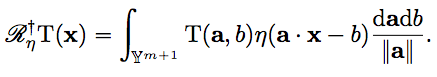
T(a,b)において,Ψに関するfのリッジレット変換を代入することによって
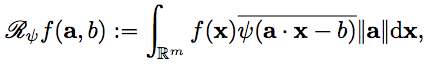
を得ます.そして,Ψとηが許容条件
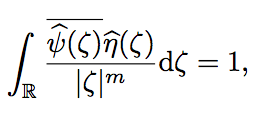
を満たす時,fに対して次のような再生公式が成り立ちます.
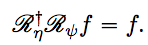
得られた再生公式を離散化することにより,活性化関数ηを用いたニューラルネットの近似性能を検証することができるとされています.
先の方法は活性化関数ηが有界関数(sigmoid関数やtanh関数)を用いた場合でのリッジレット変換であり, ReLUのような非有界関数を扱うことは想定されていませんでした.そこでSonodaらはアイデアを拡張して,活性化関数ηがReLUのような非有界かつLizorkin超関数に属するクラスであっても,ReLUネットワークを積分表現で分析できることを示しました.ReLUネットワークの万能近似性能については,フーリエスライス定理,ラドン変換,パーセバルの定理を用いた3つの再生公式によって,それを満たすことが示されています.そして,ニューラルネットが学習の結果として獲得する情報表現の正体はリッジレット変換であると述べています.
この論文の非常に興味深い主張として,許容条件に従えば,リッジレット変換を単純に離散化することによって,誤差逆伝播を経たずにネットワークを学習させることが可能であるということです.また,この理論を応用することでランダム初期化よりも有利な条件で学習させる方法も示しています[9].
深層学習の積分表現は自明ではないらしく,論文は投稿の最中ということなので,公開を待つことにします.
ニューラルネットの解析は私が強く興味を持っている研究の一つなので,今回取り上げた論文はとても面白く感じました. 私の理解が足りてない部分が多々あるので,それぞれの要素や論文についても時間が取れたら書きたいところです.
[1] Irie and Miyake. Capabilities of three-layered Perceptrons. In Proceedings of International Conference on Neural Networks. pp. 641-648 (1988).
[2] Cybenko. Approximation by superpositions of a sigmoid function. Mathematics of Control, Signals and Systems, pp. 303-314 (1989).
[3] White H. Connectionist nonparametric regression: multilayer feedforward networks can learn arbitrary mappings. Neural Networks. pp. 535-
549 (1990).
[4] Funahashi. On the approximate realization of continuous mappings by neural networks. Neural Networks. pp. 183-192 (1989).
[5] Girosi and Anzellotti. Convergence rates of approximation by translates (Tech. Rep. A.I. memo 1288). Articial Intelligence Laboratory, Massachusetts Institute of Technology (1992).
[6] Noboru Murata. An Integral representation of functions using three-layered networks and their approximation bounds. Neural Networks, Vol. 9, No. 6, pp. 947–956 (1996).
[7] Cands, E. J. Harmonic analysis of neural networks, Appl. Comput. Harmon. Anal. 6, pp. 197-218 (1999).
[8] Sho Sonoda, Noboru Murata. Neural network with unbounded activation functions is universal approximator. Appl. Comput. Harmon. Anal (2015).
[9] Sho Sonoda and Noboru Murata. Sampling hidden parameters from oracle distribution. In 24th Int. Conf. Artif. Neural Networks, Vol. 8681, pp. 539–546 (2014).
この記事はごちうさ Advent Calendar 2015 24日目の記事です.
パリのルーヴル美術館に行きたい思っているのですが,資金的な問題があるため毎日インターネットでグーグル美術館です.どうもolanleedです.
論文投稿に追われたり風邪をこじらせたり,激しいDeep LearningでMacBookが故障したりする怒涛の12月でしたが,今期のアニメ「ご注文はうさぎですか??」のおかげで正気を保てています.
ありがとう,ごちうさ.
今日はchainer-goghを使い,ごちうさの登場人物と世界の絵画を合成して「ご注文はうさぎですか?」美術展覧会を開きたいと思います.
今回用いたchainer-goghについてはこちらに書かれております.
https://research.preferred.jp/2015/09/chainer-gogh/
それではご覧下さい.
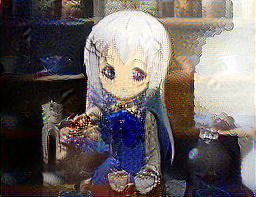
ヨハネス「牛乳を注ぐ女」とチノちゃんの合成です.
油彩のタッチにより独特な雰囲気となってますね.
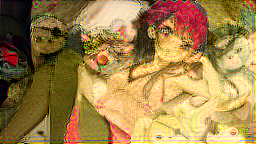
マルタン・カヴェルの絵画(名前忘れました...)とリゼさんの合成です.
淑女というタイトルをつけたんですけど,元のリゼさんがエロいためなんかエロいです.
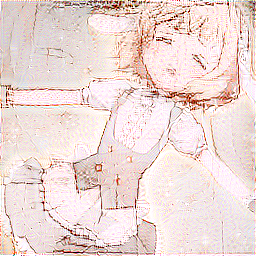
ダ・ヴィンチの人体図とシャロちゃんの合成です.
巨匠同士の絵を合成したはずなのに,なぜか落書きっぽい絵が生成された...

菊川英山「桜下美人」とチヤさんの合成です.
チヤさんと浮世絵の画風がすごくマッチしてます.
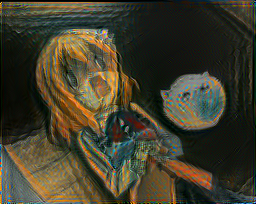
ムンク「叫び」とココアさんの合成です.個人的に一番これが好きです.
ココアさんの表情が「叫び」をよく表現してます.
この記事はDeep Learning Advent Calendar 2015 23日目の記事です.
コンピュータセキュリティシンポジウム2015 キャンドルスターセッションで(急遽)発表したものをまとめたものです.
また,私の体力が底を尽きてるので,後日に大幅な加筆・修正します.
Deep Learning Advent Calendar 21日目の記事はすいません,しばらくお待ちください...
Deep Learningが様々なタスクにおいて大きな成果を上げています.また,各種フレームワークの登場によって,Deep Learningの導入や実践する敷居が大幅に下がりました.このことから,Deep Learningを活用していこうと考えてる,あるいはすでに活用している企業や研究者が増えてきています.
Deep Learningによって従来の手法を大きく上回る性能を発揮したり,今まで実現できなかったことが実現できたりと脚光を浴びてる一方で,「あるタスクにDeep Learningを導入したものの,所望の効果が得られない」あるいは「従来の手法に性能で負けてしまった」などと,うまくいかないこともあると思います.
高いポテンシャルを秘めてることは確かのですが,Deep Learningは深いアーキテクチャなだけに深い考察が必要です.そのため,以下のことを考えなくてはなりません.
タスクごとにネットワークの構成を考えなくてなはらない
最適な(あるいは最適に近い)ハイパパラメータを求めなくてはならない
1に関しては,例えば画像認識をやる場合はCNNを使うと思います.CNNにも色々な構成があるので,問題に応じて色々構成を変えると性能が良くなることがあります.タスクに応じてstate-of-the-artな構成が公開されていることがあるので,それを用いるのが良いでしょう.
一番問題なのは,2のハイパパラメータの調整だと思います.
機械学習アルゴリズムは基本的に調整が必要なハイパパラメータが存在します.これをデタラメに調整したかと厳密に調整したかどうかで性能は雲泥の差があります.
学習させる全てのタスクにおいて共通の最適なハイパパラメータがあれば,1回だけ厳密に求めてあとは使い回せば良いのですが,基本的にタスクごとに求める必要があります.
AROWやSCWなどのオンライン線形分類器はハイパパラメータが1・2個しかないのに対して,ニューラルネットワークで構成されていることが多いDeep Learningでは,ハイパパラメータはとんでもない数になります(学習係数,隠れ層のユニット数,層の段数,epoch,dropout,momentum,weight decay,batch size...etc.).
これを探索する手法はグリッドサーチがよく用いられます.しかし,ハイパパラメータが1つ増えるたびに組み合わせの数が爆発的に増えるため,1回の試行時間が長いかつ組み合わせ数が多いDeep Learningでグリッドサーチを行うのは現実的ではありません.
では,このたくさんのハイパパラメータをどうやって調整するのでしょうか.
ランダムサンプリングとは,文字通り無作為にパラメータを抽出していく方法です.

パラメータには重要なパラメータとそうでないパラメータが存在します.グリッドサーチではこの重要なパラメータが探索から漏れてしまうことがありますが,ランダムサンプリングだとこれを拾えるだけでなく,探索の分布や幅などを変えるといったことが可能です.
他にも探索が高速,いつ計算を打ち切ってもよい,並列化が容易などでグリッドサーチよりも大きなメリットがあります.
詳細は以下の論文に書かれています.
http://www.jmlr.org/papers/volume13/bergstra12a/bergstra12a.pdf
http://papers.nips.cc/paper/4522-practical-bayesian-optimization-of-machine-learning-algorithms.pdf
関数の最適化問題とみなして,学習器を最適化していく手法が存在します.ハイパパラメータをx,学習器の誤差関数をf(x)として,このf(x)を最小にするxを求めていきます.
ただし,Deep Learningの関数の形はわからないため,BlackBox関数の最適化問題となります.
BlackBox関数の最適化手法には遺伝的アルゴリズムや差分進化法*1がなどが有名でしょう.
この項で紹介するBayesian Optimizationでは,"BlackBox関数の事前分布を仮定し,事後分布を見て最適化する"という手法をとっています.
Bayesian Optimizationの流れは以下のとおりです.
Bayesian Optimizationを実行する際に行われなければならない二つの主要な項目があります.
第一に,BlackBox関数の事前分布を仮定する必要がありますが,このBlackBox関数は直接最適化が難しいため,何かしら計算しやすい形で近似します.論文の著者は,柔軟性と扱いやすさから"Gaussian process "という手法を用いています.
Gaussian processについては以下の記事が参考になります.
Gaussian processは平均と共分散をパラメータとして受け取りますが,共分散を計算するためにはカーネルが必要です.
論文では ARD Matern 5/2と呼ばれるカーネルを利用しています.

第二に,GPでBlackbox関数を近似した後,次に調べるサンプル点を決める必要があります.これを闇雲に決めるのではなく,いくつかサンプルする候補を作って「候補の良さ」を測ります.
これに"Acquisition Function"というものを使います.これはサンプル点がf(x)を最小にするような期待値を算出するもので,算出した期待値を「候補としての良さ」とします.
Acquisition Functionには以下のようなものがあります.

これまでのベストを更新する確率が最大となる点を次のサンプル点とする.

これまでのベストに対してどれだけ更新できそうかの期待値を最大化する点を次のサンプル点とする.

平均と分散の和がもっとも大きなところを次のサンプル点とする.
論文ではEIが一番性能が良いとされています.ただし,Acquisition Functionも多峰性の関数なので,ランダムに生成した候補点を用いてとなる候補
を次のサンプル点
とします.
上記より,Bayesian Optimizationでは→
という過程を繰り返して目的関数を最小化していきます.
まとめです.
Bayesian Optimizationも実装がかなり出回っているので,そのうち試してみようと思います.
最後の方がかなり適当になってしまったので,後日加筆します.
この記事はDeep Learning Advent Calendar 5日目の記事です.
皆様,ご無沙汰にしております.olanleedです.
とうとうAdvent Calendar以外でブログを更新しないダメな人間になってしましました.更新しようといろいろ考えてたのですが,学会やらジャーナルへの論文投稿などがあって,なかなか厳しいものがありました.
この12月は異常なまでにAdvent CalendarとLTを入れたので,怒涛の更新になりそうです.お付き合いください.
それでは本題に入りたいと思います.
Deep Learningが様々な分野で大きな成果を出している現在,統計的機械翻訳でもRecurrent Neural Network(RNN)を活用した研究が成功を収めています. 今回はRNN(LSTM)を用いた翻訳モデルの一つであるSequence to Sequence Modelを実装して遊んでみました.
Sequence to Sequence Modelの主要な構成要素であるRNN-LSTMについてはこちらをご覧下さい.
seq2seqとは,異なる長さの翻訳元の単語列(Sequence)を入力とし,異なる長さの翻訳先の単語列(Sequence)を出力としてマッピングする手法です.

翻訳元の単語列ABCを4層からなるDeep LSTMで読み取っていき,隠れ状態ベクトルを求めます.End of Sentenceが来たら翻訳先の単語列WXYZを出力するような学習をさせます.この時,EncoderとDecoderとして利用するDeep LSTMは別々に学習させる必要があります.
seq2seqの著者は,性能を向上させるために
Decode時に単純なビームサーチを使用して,最も可能性の高い翻訳を探索する
5個のDeep LSTMを用いてEnsembleさせる
という手法をとっています.
しかし,それよりも単純かつ効果的な手法に「入力文を反転させる」というのがあります.翻訳元単語列ABCとあったら,CBAと読み込んでいき,翻訳先単語列WXYZを出力させる感じです.
もちろん,全部組み合わせたEnsemble+Beam Search+入力文反転が一番いい結果を出していますが,入力文反転だけでも十分な気がします.
似たような手法にRNN Encoder-Decoder Modelも存在します.こちらも読んでみるといいでしょう.
また,RNNのこういった手法は言語だけでなく画像にも使うことができ,CNNの出力をLSTMでエンコードすると,画像に対する説明文を生成できるRNNを実現することができます.


http://arxiv.org/pdf/1411.4555.pdf
Stanford University

https://cs.stanford.edu/people/karpathy/cvpr2015.pdf
seq2seqを使って素朴に機械翻訳をするのはあまりにも芸がないと考えたので,今回は「適当なタイトルを与えると,ライトノベルっぽいあらすじを生成する」というのを題材にしました.
翻訳元をタイトルにして,翻訳先をあらすじに設定します.
ライトノベルのタイトルとあらすじは各レーベルから16000件以上集めました.しかし,今回は6000件くらいで試しています.レーベルにも偏りがあります.
時間の問題もあるため,元の論文では4層のLSTMを使ってますが,2層に減らす,Dropoutをしない,など学習時間をできるだけ短くしました.性能向上のアプローチも入力文反転のみです.
ライトノベルや漫画などから無作為に選んだ学習させてないタイトル,適当に思いついたタイトルを入力して,どのような出力が返ってくるか見てみたいと思います.
学習させてないタイトル

お兄様なら巨大な陰謀の解決など朝飯前ですね.

何となく,あらすじっぽい感じがします.

こんな壮大な世界観の作品でしたっけ...

「 ツンデレ な 」を予言する、とは?

異世界に転生する定めよ 漢
適当に思いついたタイトル

ラノベっぽい! けど話が転々としたり微妙に日本語になってなかったりしてますね.

急展開すぎる...

ちょっと哲学的過ぎますね...
タイトルと関係してそうなあらすじは生成されていますが、そうでないのが多い感じがします.日本語になってない文書も見受けられます.
今回は制約が多かったので,今後は学習データを増やしたり,モデルを見直したりして実験してみたいと考えています.
また,翻訳元は文字N-gram,翻訳先は形態素N-gramでやってるのですが,こちらも文字N-gramにするかして,自然な日本語が生成できたらいいなと考えています.
なお,実装したモデルは会社から拝借したものであるためソースコードを公開することができません.ですが,GoogleのTensorflowにはseq2seqが実装されてるとのことなので,こちらを利用してみるといいかもしれません.
https://www.tensorflow.org/versions/master/tutorials/seq2seq/index.html
学習に手間取ってましたが,5000円分のAWSクーポンあったので使えばよかった ~終~
次回は前半と後半に分けてRNNで文書のポジネガ判定をやってみたいと思います.お楽しみに.
